


Depuis le 15 septembre 2026, Cloudflare a fait évoluer en profondeur la manière dont sa plateforme gère les robots d’exploration liés à l’intelligence artificielle.
Derrière cette mise à jour se cache un changement particulièrement important pour les équipes SEO : les robots dits “mixed-use”, ou crawlers à usages multiples, comme Googlebot, Bingbot ou Applebot, peuvent désormais être concernés par les règles de blocage appliquées à l’entraînement des IA.
Une mauvaise configuration peut donc avoir des conséquences qui dépassent largement la question de l’utilisation de ses contenus pour entraîner un modèle : elle peut aller jusqu’à empêcher le crawl nécessaire à la recherche traditionnelle.
Contrairement à certaines premières lectures de l’annonce, Cloudflare a également introduit un mécanisme permettant de refuser l’entraînement IA sans sacrifier sa visibilité dans les moteurs de recherche.

Envie de gagner du temps ?
Faites résumer cet article par l’IA en quelques secondes.
Search, Training et Agent : Cloudflare sépare désormais les usages
Résumé
- Depuis le 15 septembre 2026, Cloudflare a modifié la gestion des robots d’exploration liés à l’IA, affectant les crawlers comme Googlebot, Bingbot et Applebot.
- Les crawlers à usages mixtes peuvent désormais être soumis aux règles de blocage pour l’entraînement IA, ce qui peut impacter le crawl traditionnel.
- Pour refuser l’entraînement IA tout en permettant le crawl, il est nécessaire d’utiliser Disallow AI Training au lieu de simplement Block.
- Cloudflare migre les anciennes configurations vers le nouveau réglage Disallow AI Training sans couper automatiquement l’accès à Googlebot.
- Pour les nouveaux domaines monétisés par la publicité, Cloudflare recommande une configuration de Search Allow et Training Disallow AI Training.
- Les équipes SEO doivent vérifier les réglages dans Cloudflare pour éviter de bloquer les crawlers de recherche, ce qui pourrait nuire aux performances SEO.
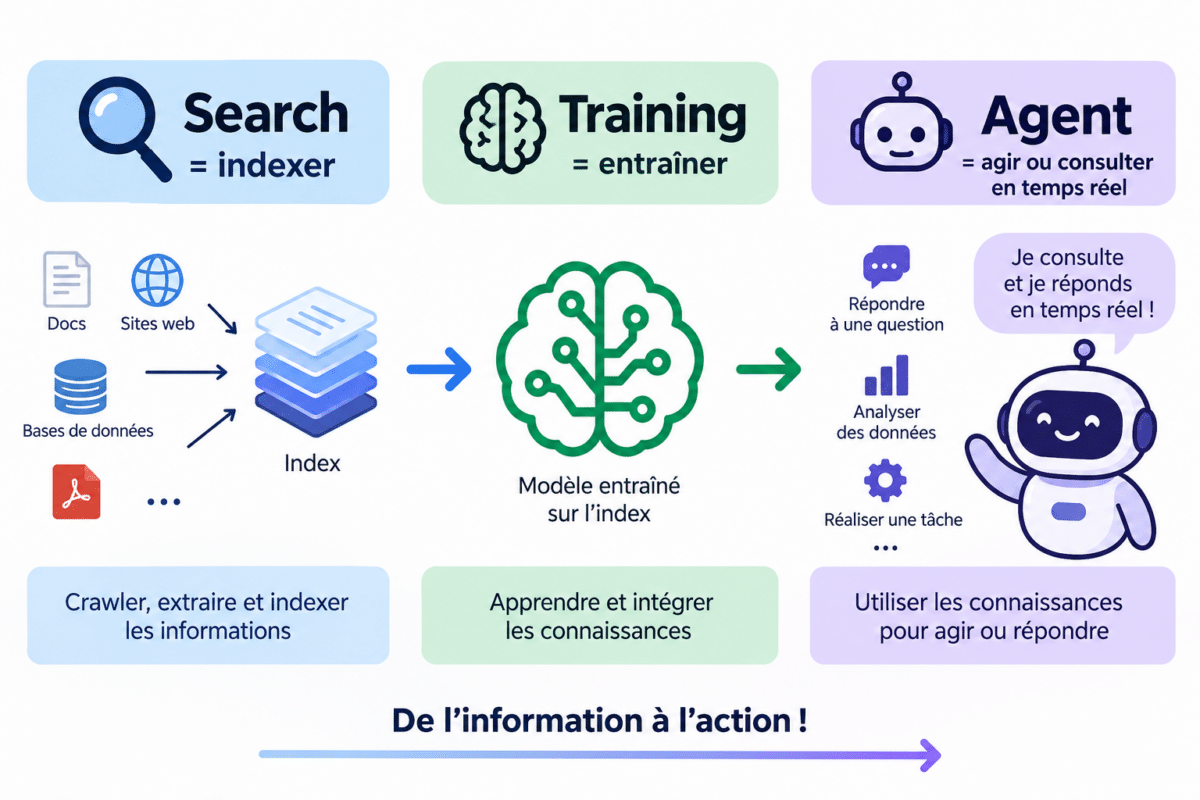
Cloudflare ne parle plus simplement de « bots IA ».
La plateforme distingue désormais trois grandes catégories de comportements :
| Catégorie | Fonction |
|---|---|
| Search | Crawlers utilisés pour construire un index de recherche |
| Training | Crawlers utilisés pour entraîner ou affiner des modèles d’IA |
| Agent | Agents qui consultent une page en temps réel pour le compte d’un utilisateur |
Cette distinction est essentielle.
Un site peut parfaitement vouloir être exploré afin d’être présent dans Google, Bing ou ChatGPT, sans pour autant accepter que ses contenus soient utilisés pour l’entraînement de futurs modèles.
C’est précisément la frontière que Cloudflare cherche désormais à matérialiser dans son interface.
Le vrai changement : Googlebot, Bingbot et Applebot deviennent sensibles aux règles de blocage Training
Le point le plus important de la mise à jour concerne les crawlers à usages mixtes (mixed-use crawlers).
Certains acteurs utilisent en effet un même crawler pour plusieurs finalités. Googlebot, Applebot ou Bingbot peuvent contribuer à l’indexation tout en étant associés, directement ou indirectement, à d’autres usages IA.
Jusqu’à présent, Cloudflare évitait d’appliquer certains blocages Training à ces crawlers afin de ne pas risquer de casser la recherche classique.
Depuis le 15 septembre, la logique change : les options “Block” et “Block on pages with ads” appliquées au Training concernent désormais également ces crawlers mixtes.
Cloudflare résume très clairement la solution :
“To stop training and keep search, use Disallow AI Training.”
Autrement dit : pour refuser l’entraînement tout en conservant la recherche, il faut désormais utiliser Disallow AI Training, et non simplement Block.
C’est une différence de configuration qui paraît minime dans une interface, mais qui peut avoir un impact SEO considérable.
Si un site choisit explicitement de bloquer un crawler mixte, Googlebot, Bingbot ou Applebot peuvent ne plus accéder aux pages concernées. À terme, cela peut affecter le crawl, la fraîcheur des contenus dans les index et leur visibilité organique.

Attention toutefois : les sites existants ne sont pas automatiquement coupés de Google
C’est probablement le point qui mérite le plus d’être clarifié.
La mise à jour du 15 septembre ne signifie pas que tous les sites qui avaient auparavant bloqué l’entraînement IA vont soudainement bloquer Googlebot.
Cloudflare indique au contraire à propos de la migration :
“Nothing, in almost every case. Your current settings carry over on their own.”
Pour les domaines existants, Cloudflare migre notamment les anciennes configurations Training = Block ou Training = Block on pages with ads vers le nouveau réglage Disallow AI Training.
L’objectif est précisément de conserver l’intention du propriétaire du site — ne pas autoriser l’entraînement — sans créer involontairement un problème de visibilité Search.
Il ne faut donc pas résumer cette mise à jour à un « Googlebot automatiquement bloqué chez tous les utilisateurs Cloudflare »
En revanche, elle justifie clairement un audit des réglages Cloudflare, car l’utilisation future des options Block devient beaucoup plus sensible.
Les nouveaux domaines monétisés par la publicité ont des réglages recommandés plus restrictifs
Cloudflare modifie également l’onboarding des nouveaux domaines ajoutés à sa plateforme à partir du 15 septembre.
Deux configurations sont désormais proposées selon que le site est ou non financé par la publicité.
Pour un nouveau domaine monétisé par la publicité, Cloudflare recommande :
| Réglage | Configuration recommandée |
|---|---|
| Search | Allow |
| Training | Disallow AI Training |
| Agent | Block on pages with ads |
| Bot Preference Sync | Enabled |
L’idée de Cloudflare est économique : lorsqu’un site dépend de l’affichage publicitaire, la visite humaine a une valeur directe. Un agent qui récupère l’information sans charger réellement l’expérience publicitaire peut court-circuiter cette monétisation.
Cloudflare expliquait déjà en juillet que « la recherche constitue le comportement qui attire le plus naturellement les visiteurs », raison pour laquelle Search reste autorisé par défaut.
Attention néanmoins à ne pas interpréter cette recommandation comme une règle universelle.
Pour une marque, un e-commerçant ou un site qui veut rester accessible aux futurs assistants capables de rechercher, comparer ou agir pour l’utilisateur, bloquer les agents peut également représenter un coût d’opportunité.
SEO et entraînement IA ne sont pas la même chose
Cette mise à jour met en lumière une confusion encore fréquente : autoriser une IA à découvrir ou citer son contenu n’implique pas nécessairement d’autoriser l’utilisation de ce contenu pour entraîner ses modèles.
Google constitue l’exemple le plus parlant.
Google propose le token Google-Extended, permettant notamment aux éditeurs de contrôler certains usages de leurs contenus par Gemini.
Google précise :
« Google-Extended n’a aucune incidence sur l’inclusion d’un site dans la recherche Google et n’est pas utilisé comme signal de classement. »
Il est donc techniquement possible de limiter certains usages IA tout en continuant à laisser Googlebot explorer normalement un site pour Google Search.
Cette distinction est d’autant plus importante qu’AI Overviews et les autres fonctionnalités IA intégrées à Google Search reposent toujours sur ses mécanismes de crawl classiques. Les contrôles Google-Extended et ceux qui gèrent l’apparition dans les résultats Search ne remplissent donc pas la même fonction.
Même logique chez OpenAI : GPTBot et OAI-SearchBot remplissent des fonctions différentes
OpenAI sépare également plusieurs usages.
Pour la visibilité dans ChatGPT Search, le crawler déterminant est notamment OAI-SearchBot.
OpenAI indique aux éditeurs souhaitant être découverts et cités dans ChatGPT :
« assurez-vous de ne pas bloquer OAI-SearchBot. »
À l’inverse, GPTBot est le crawler qu’un éditeur peut bloquer lorsqu’il souhaite exclure certaines pages d’un éventuel usage pour l’entraînement des modèles.
Il est donc possible d’avoir une stratégie du type :
OAI-SearchBot → autorisé
GPTBot → bloqué
sans renoncer mécaniquement à sa visibilité dans ChatGPT Search.
Pour une stratégie GEO, cette séparation est fondamentale.
Être accessible aux moteurs et assistants n’est pas synonyme d’accepter tous les usages possibles de son contenu.
La recommandation Peak Ace : ne bloquez pas « l’IA » en bloc
C’est probablement le principal enseignement à retenir.
La question ne devrait plus être :
« Est-ce que je bloque les bots IA ? »
Mais plutôt :
« Pour quels usages est-ce que je souhaite rendre mon contenu accessible ? »
Dans la majorité des stratégies SEO et GEO orientées visibilité, nous recommandons de raisonner ainsi :
| Paramètre | Recommandation |
|---|---|
| Search | Allow |
| Training | Allow ou Disallow AI Training selon la politique de l’entreprise |
| Agent | Allow si l’objectif est de rester accessible aux nouveaux usages agentiques |
Le point le plus important est Search = Allow.
Bloquer Search peut directement compromettre la capacité des moteurs à explorer les contenus.
Pour Training, la décision est différente. Une entreprise peut souhaiter autoriser l’entraînement, ou au contraire protéger ses contenus propriétaires. Il n’est pas nécessaire de laisser entraîner un modèle simplement pour espérer être visible dans les résultats de recherche.
Enfin, la catégorie Agent va devenir de plus en plus stratégique.
Les futurs parcours ne se limiteront plus à un utilisateur cliquant sur dix liens dans une SERP. Un agent pourra rechercher une information, comparer plusieurs offres, consulter une disponibilité ou préparer une transaction pour son utilisateur.
Bloquer systématiquement ces agents, c’est prendre le risque de devenir invisible pour cette nouvelle catégorie d’intermédiaires numériques.
Ce qu’il faut vérifier dès maintenant dans Cloudflare
Pour les sites utilisant Cloudflare, nous recommandons donc de réaliser un contrôle rapide de la configuration.
Dans Security Settings > Configure AI bot policies, vérifiez notamment :
- que Search est configuré sur Allow si le site doit rester accessible aux moteurs ;
- que le réglage Training correspond réellement à la politique souhaitée ;
- que Disallow AI Training est utilisé plutôt que Block lorsqu’on souhaite refuser l’entraînement sans sacrifier les crawlers Search compatibles ;
- que le réglage Agent correspond à la stratégie GEO et business du site ;
- que le
robots.txtgénéré ou synchronisé par Bot Preference Sync correspond bien aux intentions définies ; - qu’aucune règle WAF ou règle personnalisée ne bloque parallèlement les crawlers que vous souhaitez autoriser.
Cloudflare rappelle par ailleurs explicitement que bloquer des crawlers de moteurs de recherche peut avoir un impact négatif sur les performances SEO : ces crawlers ne pourraient plus indexer correctement les contenus.
Du SEO au GEO : contrôler l’usage sans disparaître
La mise à jour de Cloudflare est intéressante parce qu’elle matérialise une évolution plus large du Web.
Pendant longtemps, le contrat était relativement simple : un crawler venait récupérer une page afin de l’indexer, puis un moteur renvoyait potentiellement du trafic vers cette page.
Avec l’IA générative, les usages se multiplient : indexation, grounding, génération de réponses, entraînement, navigation agentique, extraction de données ou transaction.
Les propriétaires de sites ont donc besoin de contrôles beaucoup plus fins.
La bonne stratégie n’est pas nécessairement d’ouvrir toutes les portes.
Mais elle n’est certainement plus non plus de « bloquer les IA » indistinctement.
Pour les équipes SEO et GEO, le sujet devient désormais un enjeu de gouvernance : quels systèmes doivent pouvoir accéder à quelles informations, dans quel but, et avec quel impact sur la visibilité de la marque ?
La mise à jour Cloudflare du 15 septembre 2026 rend cette question beaucoup plus concrète.
Et elle donne une raison supplémentaire d’intégrer désormais les CDN, WAF, fichiers robots.txt et politiques de bots dans les audits SEO et GEO : une excellente stratégie de contenu ne sert à rien si les systèmes censés la découvrir ne peuvent tout simplement pas y accéder.